书名:DeepSeek Harness:一切皆插件的AI智能体构建与工程应用
本书由人民邮电出版社发行数字版。版权所有,侵权必究。
您购买的人民邮电出版社电子书仅供您个人使用,未经授权,不得以任何方式复制和传播本书内容。
我们愿意相信读者具有这样的良知和觉悟,与我们共同保护知识产权。
如果购买者有侵权行为,我们可能对该用户实施包括但不限于关闭该帐号等维权措施,并可能追究法律责任。
著 艾长青 艾勇青 李洋
责任编辑 傅道坤
人民邮电出版社出版发行 北京市丰台区成寿寺路11号
邮编 100164 电子邮件 315@ptpress.com.cn
网址 http://www.ptpress.com.cn
读者服务热线:(010)81055410
反盗版热线:(010)81055315
DeepSeek Harness是DeepSeek开源的AI Agent运行底座,秉持“一切皆插件”的核心理念,能够灵活组装各类智能体能力,把大模型的对话能力延伸到真实业务任务场景。它拥有可替换、可追溯的显著特点,有效改善传统智能体黑盒运行、问题难以复现的痛点,为个人、团队与企业搭建可控的智能应用,提供了一套成熟的工程化实现方案。
本书兼顾实操上手与底层原理,系统讲解DeepSeek Harness的环境搭建、插件化架构、配置体系、调试诊断以及工程治理实践。全书共分为四个部分:第1部分指导读者搭建安全可控的本地运行环境,完成首个可验证的智能体任务;第2部分剖析插件发现、能力组合、任务通信、生命周期管理与故障恢复整套运行机制;第3部分从最小原型入手,演示各类插件的开发、组合、测试与发布流程;第4部分结合真实工作流案例,展示如何整合模型、工具与人工审核,搭建可复核的端到端业务方案。全书基于项目0.1.1‑rc.2快照版本撰写,配套大量可复现的操作示例,帮助读者理解插件化智能体底座的工程内核。
本书适合AI Agent前后端开发者、平台工程师、大模型应用落地技术人员、智能体调试测试人员,以及对Agent底层架构感兴趣的技术爱好者阅读。
艾长青(@acedar),头部互联网大厂AI技术算法专家、深圳市产业发展与创新人才奖获得者、51CTO高级讲师,AI技术自媒体博主,《Claude Code 技术架构深度解析:Harness工程与AI编程新范式》《OpenClaw 觉醒:基于AI智能体的超级生产力构建指南》两书的作者。长期深耕人工智能算法领域,累计申请人工智能等相关专利30余项。聚焦AI技术普及与人才培养,独立研发AI专业课程10余门,形成“前沿技术研究—工程化落地—技术教学传播”的多维能力闭环,始终致力于以算法创新破解业务难题,推动 AI 技术的价值落地与行业人才的成长。
艾勇青,西北工业大学硕士,资深AI技术专家,现任国内物联网上市集团 IT 总监。长期深耕AI智能体(AI Agent)领域,专注智能体执行框架与底层架构研究,拥有丰富的一线项目落地经验,在大模型对接真实业务场景、复杂任务编排、智能体规模化工程实践方面,沉淀了体系化的理论认知与实战积累。
李洋,深圳市蛟龙腾飞网络科技有限公司CEO兼CTO。华为HarmonyOS领域HDE华为开发者专家,曾获2024鸿蒙先锋优秀HDE、2025首批鸿蒙极客称号;担任华为开发者联盟学堂、鸿蒙生态服务学堂认证讲师。同时为开放原子开源基金会OpenHarmony银牌开源教育讲师(2021‑2024)、校源行开源大使,2024年度OpenHarmony MVP。著有《云品牌战略》《鸿蒙生态》《HarmonyOS 原子化服务卡片原理与实战》,并参与合著《星河璀璨 —— 鸿蒙操作系统引领数字化发展》。
谨将本书献给我的爱人陈丹、孩子艾米果,感谢你们一直以来的支持与鼓励。还要把本书献给我的父母以及其他家人,感谢你们的理解和包容。同时感谢我的合作者陈济棠先生和陈文浩先生,与我同舟共济、全程携手完成本书的创作。最后,把本书献给所有在AI时代勇于探索、执着创新的开发者。
——艾长青
谨将本书献给我的家人,感谢你们在我工作繁忙之余,依然给予我充分的理解与支持,让我能从容地参与到这项有意义的工作中。愿这本书能为所有在AI智能体领域探索的开发者们提供一份切实的参考。技术之路漫漫,愿我们都能保持好奇,步履不停,在代码与逻辑的世界里找到属于自己的光亮。
——艾勇青
谨将本书先给我的家人尹皎洁、李尹靖婷、李尹靖轩,感恩你们始终给予我写作路上的支持与鼓励。
——李洋
本书的完成离不开开源社区、技术同行与读者的长期启发。首先,感谢DeepSeek Harness及其依赖生态的开发者与贡献者。开源项目将正在演进的架构、代码、文档与讨论公开给社区,使开发者能够理解、验证并扩展智能体运行框架;本书对插件化架构、运行方案和可追溯任务的讨论,也由此获得了重要的实践参照。
感谢在AI算法、软件工程、智能体系统、数据研究和开发者教育领域持续分享经验的技术同行。许多看似抽象的工程问题,例如权限边界、工具失败、配置漂移、模型替换与版本回退,只有在长期的项目实践和坦诚的复盘中才会显露出真正的复杂性。正是这些经验提醒我们:技术写作既要讲清“怎样做”,也要如实说明“何时不应做”以及“出了问题如何处理”。
感谢每一位愿意阅读、验证并提出反馈的读者。智能体技术变化迅速,本书不可能覆盖所有模型、工具、业务场景与未来版本。期待读者把书中的方法转化为自己的实验、插件、测试和工作流,并以严谨的实践帮助这套知识持续完善。
过去两年,大语言模型技术快速迭代,推动“智能体”从概念原型快步走向工程落地。人们不再仅仅满足于大模型完成单次问答,更期待智能体能够理解任务目标、读取材料、调用工具、处理异常、输出交付结果,在多轮步骤之间维持状态,并接受人工监督。而真正的工程难点也随之显现:模型能否生成看似通顺的文本,仅仅是智能体系统的起点;能否在真实目录、真实数据、真实权限、真实协作流程之下,安全、稳定、可复核地完成任务,才是落地的核心所在。
这正是Agent Harness(智能体运行框架)的价值。大模型承担理解与推理工作,运行框架则负责将模型对接受控运行环境,赋予模型调用工具、执行任务、留存状态、接受约束、留存审计证据的能力。DeepSeek Harness将这套工程思路进一步深化:它没有将模型适配、工具注册、任务记录、沙箱、任务调度、用户界面固化为不可改动的核心内核,而是把以上全部能力抽象为插件单元,可根据业务任务按需选用、替换与组合。官方设计文档将模型、工具、技能、会话、沙箱、存储、执行循环、调度模块及 UI 统一纳入插件体系,依托Cordis完成插件挂载、卸载与依赖关系管理。
当然,“一切皆插件”并不代表系统可以无边界肆意扩展。恰恰相反,这套架构对开发者提出了更高的能力边界思考要求:某项操作应当交由模型直接处理,还是通过工具执行,抑或是必须经过人工确认?只读巡检任务与受控修改任务,是否应当复用同一套权限策略?当数据源、分析规则、模型服务发生变更时,如何定位结论差异的真实来源?插件加载失败、工具调用报错、任务意外中断,如何依托记录还原现场并实现安全恢复?这些问题,正是区分演示Demo与可维护工程级智能体系统的关键。
DeepSeek Harness为上述工程难题提供了一套极具参考价值的实现路径。它的运行实例由多层有序配置共同组装生成插件能力树;运行方案(Profile)可以叠加功能包(Bundle)、接入外部插件、保存用户自定义覆盖配置;插件向共享上下文输出服务、类型化事件以及可撤销的副作用。依托这套机制,开发者无需修改核心源代码,就可以组装适配不同业务场景的能力集合。与此同时,任务全过程被记录为追加式会话事件日志,模型可见的系统提示、工具调用与返回结果、子智能体调度、上下文注入全部归入同一事件流,为会话恢复、分支复刻、检索回放打下数据基础。
本书并非简单的安装操作手册,也不打算将智能体开发简化为若干提示词模板。我们希望引导读者建立软件工程化的思维模式:先明确任务目标、输入范围、权限边界与验收标准,再为任务装配模型、工具、存储、记录、人工确认等能力;优先保障每一步行为可验证,再去追求自动化与规模化;预先为替换、升级、回退、审计预留机制,之后再构建复杂工作流。书中的研发质量、个人量化研究案例,正是遵循该原则设计:让智能体具备行动能力的同时,保证行动范围明确、过程可回放、结果可复核。
选用DeepSeek Harness,也需要正视项目尚处于快速演进阶段的客观现状。DeepSeek 官方将其定位为开发者预览版本,明确提示核心插件与 API 仍会迭代,存在发生不兼容破坏性变更的可能性。因此,书中全部操作与案例,仅代表对应版本下的工程方法与实践路径,并不构成对未来版本行为的永久承诺。实际项目使用时,应当锁定依赖版本,留存运行配置与任务记录,仔细阅读版本升级说明,先在隔离环境完成验证,再迁移至正式工作目录或者业务流程。
本书三位作者分别深耕AI算法、智能体工程、信息技术管理与开发者教育领域。多元的工程背景,让我们在写作过程中形成统一的写作导向:既深挖底层架构原理,也重视可落地的配置、测试、交付实践;既看到大模型带来的业务效率提升机遇,也时刻强调数据、权限、成本与责任边界。希望本书能够帮助读者在瞬息万变的智能体技术浪潮中,搭建属于自己、可组合、可治理的智能体系统。
全书遵循“启动上手→原理理解→插件开发→项目交付”的学习路径,分为4个部分,共计15章。读者既可以顺序阅读,完成完整的能力学习;也可在掌握基础之后,根据实际问题按需跳转对应章节。
第1部分:跑起来——认识并启动DeepSeek Harness
本部分解答“为什么需要智能体运行框架,以及如何安全地把系统跑通”。第1章厘清大模型、智能体、运行平台三者职责,阐释DeepSeek Harness在可组合、可追溯、开放可控方面的设计理念与适用边界。第2章指导搭建隔离本地环境,完成模型服务、密钥、工作目录、运行状态的全套配置校验。第3章以小型可验证任务作为切入点,观察模型、文件访问、工具执行、任务记录如何协同工作,完成从图形界面到命令行自动化运行的过渡。
第2部分:看明白——一切皆插件的架构与运行机制
本部分从系统内部拆解“一切皆插件”的真实含义。第4章搭建插件架构全景,说明内核、插件能力树、各类插件的职责划分;第5章讲解插件发现、加载、依赖解析、配置覆盖,以及运行方案的完整生成流程;第6章顺着单次任务完整执行链路,解析任务记录、模型请求、工具调用、结果回传如何共同驱动任务推进;第7章聚焦插件生命周期、安全审批、环境隔离与故障恢复机制;第8章基于统一对比任务,阐述可替换、可追溯、可维护的工程价值,以及采用该框架需要权衡的约束与成本。
第3部分:造出来 —— 插件开发、组合与交付
本部分将架构认知转化为实际工程能力。第9章从最小插件原型入手,讲解能力入口、依赖声明、配置参数、资源回收、诊断日志;第10章围绕工具插件,讲解如何依靠清晰任务契约、结构化输入输出、超时与异常反馈,赋予智能体可校验的行动能力;第11章面向数据处理、研究报告类场景,介绍数据读取、规则运算、报告生成、风险审查与归档的设计思路;第12章以只读巡检、受控修改、批量处理三类典型方案,演示插件组合、替换、冲突隔离、模板复用;第13章落脚于质量校验、打包发布、升级回退、供应链安全,让开发的插件具备可对外交付的条件。
第4部分:用起来 —— 两个差异化的完整项目实战
本部分通过两套完整案例,落地前文介绍的工程方法论。第14章搭建插件化研发质量工作流,整合代码巡检、变更分析、测试校验、报告生成、人工审批,形成只读审查、受控修复两套运行方案,依托任务记录实现复盘与团队复用。第15章搭建个人量化研究工作流,将数据读取、规则运算、风险审查、报告归档纳入完整可追溯链路,探讨数据版本、计算异常、人工确认、研究辅助的边界(注:该案例仅演示工作流设计思路,不构成任何投资建议).
• 立足于运行框架,而非单点提示词技巧。本书将模型、工具、会话、沙箱、存储、执行循环、调度、U 统一置于插件化视角下分析,帮助读者建立面向真实业务任务的系统思维,而不局限于单轮对话与提示词调优。
• 以“可替换”作为工程设计主线。借助运行方案、配置覆盖、插件组合机制,讲解模型、工具、数据源、权限策略的替换手段,降低各业务能力之间的耦合,为后续迭代、迁移、复用预留空间。
• 以“可追溯”约束完整任务链路。全书贯穿任务定义、输入溯源、工具调用、结果回传、日志快照、回放验收全流程,让输出结论具备完整证据链,便于排错、审计与复盘。
• 以“安全治理”约束智能体行动边界。针对目录隔离、权限管控、人工确认、异常处理、版本回退、供应链风险等问题,在设计‑开发‑交付全流程给出关注点,在获得自动化收益的同时,控制对真实资产的风险。
• 以“可交付”作为插件成果的评判标准。覆盖原型开发、测试验证、打包安装、升级卸载、版本文档全链路,帮助个人实验沉淀为团队可以复用的工程资产。
• 完整业务案例打通理论与实践。通过研发质量、个人量化研究两套差异化项目,演示从需求梳理到运行验收复盘的全流程,把抽象架构落地为可实操的工作流。
本书面向具备一定计算机基础,希望把大模型能力对接真实业务任务环境的读者。不同背景的读者,可以结合自身目标选择阅读路径。
• AI 应用开发者、软件工程师、架构师:建议重点阅读第4‑13章,在独立测试目录完成一套工具插件与运行方案实践,结合日志与测试用例复盘,将插件架构认知转化为开发能力。
• 技术负责人、平台工程师、运维人员:建议优先阅读第2、5、7、8、12、13、14章。优先搭建目录隔离、密钥管理、权限审批、配置快照、故障回退机制。在拓展自动化能力之前,先把运行边界、变更治理落实到位,其重要性往往高于堆砌更多新功能。
• 数据分析、科研研究人员:建议重点阅读第3、6、11、12、15章。实践时先把数据源、版本、计算规则、人工确认点固化为明确任务契约,再逐步实现自动化,保证结论、证据、过程可以互相印证。
• 产品经理、技术型业务人员、AI爱好者:建议从第1‑3章入门,再阅读第8、14、15章。推荐以边界清晰的小型任务作为实践起点,观察各类能力如何组合、结果如何验收,循序渐进扩充工具、数据、协作环节。
阅读本书前,建议读者掌握基础命令行与文件管理操作,会使用Node.js、Git等开发工具;理解环境变量、API密钥的基础概念;对大语言模型、工具调用、JSON 具备初步认知。
本书第一部分提供上手指引,但不会替代操作系统、网络、版本控制、编程的基础教学。书中全部代码与配置务必在测试目录、受限凭据环境下运行,切勿直接在重要项目、生产目录、敏感数据上执行未经验证的自动化操作。
本部分带领读者从零完成DeepSeek Harness的认知与上手实操。开篇先厘清该平台所要解决的核心问题,帮助读者判断,哪些业务场景适合选用这套具备插件化、组件可替换、全过程可追溯特性的智能体运行平台。随后循序渐进完成本地环境搭建:覆盖Windows、macOS、Linux多操作系统,完成Node.js、npm、pnpm运行工具部署,搭建隔离可控的本地学习环境,掌握Web服务启动、模型凭据配置、工作目录选定等关键操作。最后通过一次完整的小型实操任务,直观体验模型推理、文件访问、工具调用、任务轨迹记录与人机人工确认相互配合,产出一份可核验的交付成果。
读完本部分,你将不只是可以成功打开操作界面,更能够在本机安全启动运行实例,辨别工作目录的访问边界,独立完成首次完整任务,并妥善留存关键运行证据与材料。
本部分包含如下章节:
• 第1章,“为什么选择DeepSeek Harness——智能体工具的新选择”;
• 第2章,“安装与配置——建立安全可控的本地环境”;
• 第3章,“第一次任务——观察插件化智能体如何工作”。
当前大语言模型的推理能力持续突破,不少开发者在构建 AI 智能体应用时,很容易陷入一个典型误区:将项目成败完全寄托于大模型本身。大家会花大量时间挑选参数更强、测评分数更高的模型,想当然认为,只要模型足够聪明,就能自动处理各类复杂的现实工作。但进入落地阶段后往往事与愿违:模型输出的文本很漂亮,却无法操作本地文件、执行指令;任务执行过程黑盒化,出了问题无从追溯;生成的代码、报告只是一次性输出,难以迭代维护。
智能体想要真正落地完成工程任务,强大模型只是其中一环。一套能够管理环境交互、工具调用、权限约束、过程留痕的运行底座,同样不可或缺。本章并不打算堆砌指标去证明 DeepSeek Harness 的性能有多强悍,核心要回答的问题是:在纷繁的智能体工具生态中,我们究竟出于哪些理由选择 DeepSeek Harness。
本章首先厘清大语言模型(LLM)、智能体(Agent)与运行平台(Harness)三者的职责边界,拆解运行平台在真实项目里必须解决的工程难题:环境感知、工具集成、任务持续推进、权限与状态管控、过程留痕以及可复核交付。全书设置了统一教学案例——搭建一套本地运行、无任何外部依赖的模拟灯光秀前端项目,借助这个实操案例,具象展现四大核心价值:插件化组合、能力可替换、全程可追溯、成果可维护交付。章节末尾提供运行平台选型评估表与理性选型方法论,帮助读者在项目早期避开主观判断的陷阱,做出匹配业务现实的技术决策。
绝大多数使用者接触人工智能,都是从大模型对话开始:输入问题,获取一段文本回复。但对话交互仅仅是智能能力最表层的形态。一旦我们希望AI不再局限于输出文字,而是能够操作文件、执行命令、完成完整业务任务,就不能只依靠大模型本身。智能体承接了行动决策的角色,而想要让智能体安全、可控地在真实环境开展工作,则必须引入专门的运行平台。下面我们首先厘清三者各自的职责定位。
完整的智能体工作体系由大语言模型、智能体、运行平台三者协同构成,每个组件各司其职,定位不可混淆。我们分别对三者的能力边界展开说明。
• 大语言模型(LLM):擅长基于自然语言与结构化提示词上下文完成推理和内容生成,但模型本身并不具备对外部环境的原生感知与操控能力,文件系统、命令行工具、网络资源、持久化状态都不在它的直接掌控范围内。它仅负责提供认知理解与语言生成能力,并不能直接产出一套可落地交付的完整工作流。
• 智能体(Agent):在既定任务目标与策略约束之下,调度模型、工具以及各类上下文材料,循环执行 “决策‑调用‑观察‑再决策” 的工作流程。对比单次问答模式,智能体更像是一个兼具记忆能力与执行能力的任务角色。
• 运行平台(Harness):为智能体搭建完整运行环境,赋予智能体感知环境、执行操作、留存状态、接受审核以及支持迭代维护的能力。其具体能力包含模型接入、工具与可执行技能的统一接口、工作区与会话(存储对话与过程材料)、调度与执行循环、权限策略管理、过程可追溯记录以及面向用户的交互界面。DeepSeek 官方将智能体抽象定义为 Model + Harness(模型 + 运行平台),同时提出核心理念 “Everything is a plugin(一切皆插件)”。模型、工具、技能、会话、沙箱、存储、执行循环、调度模块、用户界面等组件,都能够以插件形式完成组合、替换与扩展,依托这套统一运行平台承载真实业务工作。
三者的职责边界关系可以参考图1-1。
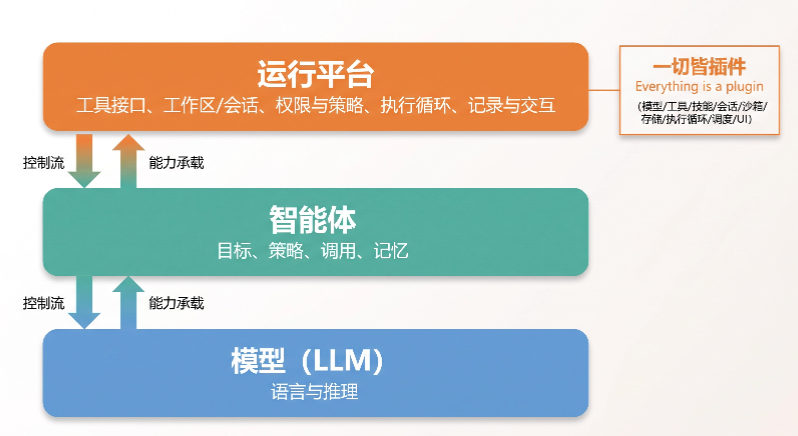
图1-1 模型—智能体—运行平台的职责边界
通过图 1‑1 呈现的分层关系,我们可以跳出固有的思维误区:不要把“提升模型自身能力”当作智能体落地的唯一手段。选择运行平台的核心,并不在于改造大模型本体,而是为模型搭建一套可核验的行动通道与材料通道,依靠统一机制,把完整任务过程沉淀为可交付文档与可追溯记录。
当智能体脱离演示Demo,投入真实生产环境,工作内容就不再局限于简单对话,还需要处理大量琐碎却至关重要的工程问题。
• 文件与目录:明确文件读取范围与写入路径,防范越权操作;文件写入环节可配置人工确认机制,保障每一处修改都有据可查。
• 工具与脚本:调用命令行时限定工作区作用域,持久保存命令以及执行结果;任务失败时留存完整上下文,便于问题复现排查。
• 凭据与密钥:明确凭据保管与引用机制,前端仅展示脱敏后的信息;支持凭据在不同会话、工作区之间灵活实现继承或者隔离。
• 权限与策略:区分需要人工审批和允许自动执行的操作;厘清默认策略下的能力边界,落实平台临时根目录对应的约束规则。
• 记录与复核:聚合对话消息、工具调用参数与返回结果、工作区路径、模型可访问素材,串联形成完整的任务材料链,支撑人工复核与审计工作。
• 交付与维护:保障生成报告、代码补丁具备可维护性;开展后续迭代时,可以在保留历史记录的前提下替换局部功能模块。
DeepSeek Harness的设计初衷,就是在「模型 + 运行平台」框架下,为上述工程难题提供统一解决方案。Web Agent 能够在选定工作区内完成文件读写、运行命令、委派子任务、维护执行计划;操作是否需要人工审批完全由权限策略决定,不能默认所有写入操作都必须经过人工确认。本书第3章将以本地无外部依赖的模拟灯光秀前端项目作为实践案例:智能体先列出待创建文件 index.html、style.css、app.js、README.md,待读者确认之后才执行写入,完成后通过浏览器预览页面效果。由此形成完整业务闭环:模型方案 — 文件变更 — 任务过程 — 人工确认 — 页面效果验收。
如果我们的目标从“使用能力强大的大模型” 转向 “交付可落地的智能体业务”,就不能仅凭主观感受选型,建议借助可填写的评估表开展客观评判。表1-1汇总核心评估维度,本书后续实验中,读者可以将各个候选平台的实测情况填写至“证据”栏,全部记录完成后再做综合对比。
表1-1 候选平台能力为度登记表
| 判断维度 |
观察要点 |
证据(文档/命令/截图引用,自填) |
风险与边界(自填) |
|---|---|---|---|
| 扩展粒度 |
能力是否按模型/工具/技能/会话/执行循环/调度/UI等插件化拆分 |
||
| 配置方式 |
是否支持命令行profile/补丁叠加、目录与工作区分层配置、只写凭据与引用 |
||
| 替换范围 |
单能力可替换的范围与代价(如更换模型提供方、替换执行循环) |
||
| 过程记录 |
是否能将消息、工具参数/结果、工作区路径与上下文纳入可追溯材料 |
||
| 权限控制 |
工作区边界、平台临时根目录、审批策略与默认会话权限 |
||
| 交付维护成本 |
报告/修改落地路径、长期演进与合规审计的投入预估 |
只有平台各项能力匹配项目预期,才值得投入资源开展PoC(Proof of Concept,概念验证)以及小规模上线;反之应当优先选用轻量化方案,例如一次性问答或者独立脚本。本书 1.3节会提供完整对比维度表以及审慎选型流程,帮助读者快速匹配自身业务场景。
明确了大模型、智能体与运行平台三者的分工之后,我们进一步聚焦DeepSeek Harness本身。它的核心优势并不来自某一项孤立的功能,而是整套运行平台设计理念带来的综合能力,主要体现在一切皆插件、全程可追溯、开放可控三个方面。
“Everything is a plugin” (一切皆插件)并不是一句宣传口号,而是一套落地的工程实现思路。平台将模型、工具、技能、会话、沙箱、存储、执行循环、调度模块、用户界面等组件,统一抽象成一套能够自由组合、替换与扩展的能力模块。这套插件化设计会带来三方面显著影响。
• 适配性提升:面对同一任务,使用者可以更换模型服务商与默认大模型,也能够替换执行循环乃至用户界面,以此适配不同团队规范与软硬件环境约束。
• 迁移成本可控:当某项能力无法满足业务需求时,仅需替换对应模块,无需推倒重构整套技术栈。举个典型场景:先在 Web 交互界面完成业务流程验证,随后切换至 headless 模式接入 CI 流水线,整个过程只需要替换交互界面与启动方式即可。
• 学习与配置成本有所增加:插件化体系引入了更多概念与配置项,开发者需要厘清各个能力模块的替换范围、边界条件以及替换操作带来的成本代价。
本书实操案例中,我们重点体验「模型候选 — 工具事实 — 任务记录 — 人工确认 — 可维护交付」这条工作链路。为降低上手门槛、保证实验可复现,不会深入讲解插件树、加载顺序、组件生命周期等底层内部机制。官方文档与项目介绍将 DeepSeek Harness 定位为基于 Cordis 的开源智能体运行平台,其中 Cordis 是支撑整套体系的插件元框架,负责管理插件生命周期与依赖关系,实现组件热插拔能力,平台核心原则就是支持插件的组合、替换与扩展。模型候选到可维护交付的完整材料链可参见图1-2。
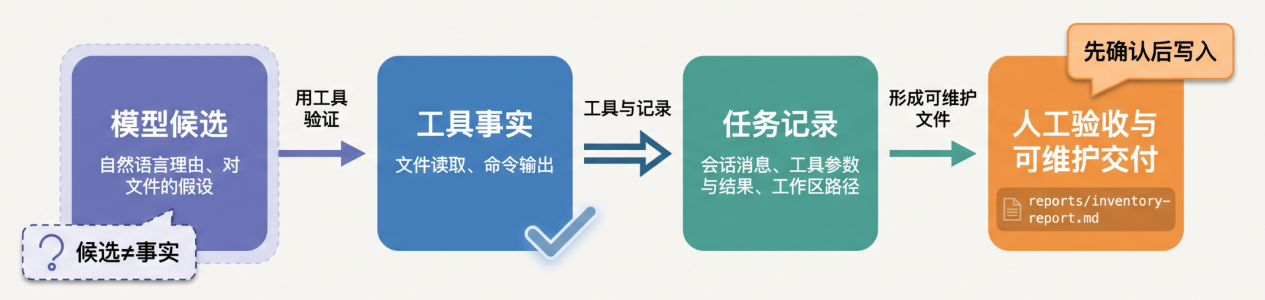
图 1-2 从模型候选到可维护交付的“材料链”
提到可追溯,需要先厘清一个认知:可追溯不等于日志信息面面俱到,也不代表系统自带天然合规属性。它的真实含义是:将任务相关的对话消息、工具调用参数与返回结果、工作区路径以及各类上下文素材,尽可能归集串联为会话与任务记录,方便事后开展溯源复核,也便于后续迭代优化。
• Web 使用场景:智能体在选定的工作区内完成文件读写、执行命令、委派子任务、维护执行计划。所有操作行为和上下文信息都会沉淀为连续的会话记录,使用者可以在界面上对照查看,区分模型内部推演想法与工具返回的客观事实。是否触发人工审批由权限策略决定;本书全部实验案例统一采用写入前人工确认的约束规则。
• CLI 使用场景:headless 无界面模式支持单次运行一个持久化会话,会话结束后将最后一条非空的模型输出打印至标准输出,同时通过进程退出码区分任务正常完成与各类异常终止状态。必要时还可以对接外部日志与遥测组件完成记录审计。
• 遥测数据安全提醒:遥测数据默认保存在本地;如果手动开启 OTLP(OpenTelemetry Protocol,用于导出日志、链路追踪、指标数据的标准化协议),消息内容、工具调用参数、工作区路径这类敏感元数据就会向外输出。因此务必在隔离受控环境开展测试,防止业务敏感信息泄露到组织外部。
回到模拟灯光秀前端项目案例:智能体首先输出页面结构与交互设计方案,经过确认写入文件后,再通过浏览器直观展示运行效果。依托完整的工具调用记录与会话材料,使用者能够回溯智能体原本的设计计划,对比实际产生的文件改动;文件创建的决定权掌握在使用者手中。任务最终产出四份可迭代维护的本地文件与可预览网页,而不是问答模式下转瞬即逝的文字描述。
这里所说的 “开放”,指平台能够对接用户自有业务环境;“可控” 则代表智能体不会不受约束地在本地环境随意执行操作。基于本书所使用的版本,下面梳理这套平台 “可定制同时风险可控” 的关键设计要点。
• 模型与服务商管理:在设置‑模型页面中填写第三方服务商密钥。密钥采用只写模式,前端仅展示脱敏标识;真实凭据存储于 $DSH_HOME/.credentials.yaml,配置文件只保存凭据引用,不存放明文密钥。自定义服务商包含固定不变的 Provider ID、接口基础地址、通信协议、凭据信息以及至少一个可用模型。Provider ID 会被请求、会话、默认模型、凭据多处引用,不可随意修改。模型配置修改后,下一次请求即可生效,无需重启服务,支持在不中断当前会话的前提下切换候选模型。
• 工作区与会话机制:全新 Web 界面下,用户必须手动添加并选中工作区之后,智能体才接收任务指令。新建会话默认权限为 workspace‑write,Bash 命令执行、文件修改操作被限定在当前会话工作区以及平台临时根目录范围。但需要注意,读取操作、网络访问、进程可见性并未做到完整沙箱隔离,该机制不能等同于生产环境级别的安全防护。
• 服务启动与访问限制:快速启动命令为 npx @deepseek‑ai/dsh web,服务默认仅监听本机回环地址 127.0.0.1:3080;当前 CLI 层面会禁止使用 --host 0.0.0.0 参数。仅建议在本机做实验,切勿直接暴露到公网,也不要直接当作生产系统使用。
• 配置与审计能力:配置文件采用叠加机制,生效优先级依次为 bundle patch、profile 配置文件 cordis.patch.yml、用户家目录下 $DSH_HOME/cordis.patch.yml、命令行传入的 --patch 参数;同一配置项,后加载的配置会覆盖前者,patch 是整体替换配置而非深度合并字段。借助 --dump‑default‑config 和 --dump‑config 参数,可以在不启动应用的前提下查看最终合并后的完整配置,该参数不可搭配 app 参数。上线前可以预先核验即将生效的全部配置,降低隐藏风险。
以上一系列设计共同搭建起开放可控的工程边界:既允许接入自研模型与自有业务环境,又依靠工作区隔离、权限策略、配置核验多重手段约束、审计智能体行为,把 “能够跑通功能” 升级为 “可以稳定维护地运行”。
市面上智能体相关工具种类繁多,不同工具的设计目标、工程实现思路差异很大。只有理清各类方案的定位边界,才能结合自身业务条件判断 DeepSeek Harness 是否适配项目需求。本节将从工程实现角度开展横向对比,梳理它的适用场景,同时明确哪些场景并不建议选用该平台。
开展运行平台选型时,不要仅凭对模型性能的主观印象做判断,应当站在工程落地视角,重点考察工具的集成方式、迭代演进能力以及成果交付模式。表 1‑2 提供一套中立对比框架,不针对具体产品点名排名。框架将市面上常见方案划分为三类:固定功能聊天工具、单一代理/脚本、插件化运行平台,方便读者快速对齐自身业务预期。DeepSeek Harness 就归属于插件化运行平台这一类别。
表1-2 通用框架能力维度对比
| 维度 |
固定功能聊天工具 |
单一代理/脚本 |
插件化运行平台 |
何时重要 |
|---|---|---|---|---|
| 扩展粒度 |
仅提供少量可选能力,模块难以拆分 |
整体围绕脚本或单体代理构建,局部修改容易牵动全部逻辑 |
模型/工具/技能/会话/执行循环/调度/UI等均可拆分为独立插件 |
当希望替换单项能力,而不需要重写整套系统 |
| 配置方式 |
UI界面勾选或者少量参数配置 |
配置硬编码在代码内,或依靠环境变量 |
支持 profile / 补丁叠加、用户家目录与工作区分层配置、凭据引用机制 |
当业务需要区分多环境配置,并且要求配置可审计 |
| 替换范围 |
替换能力有限 |
替换能力中等 |
替换范围广(但需要理解模块边界与依赖关系) |
当需要测试多款模型、不同执行循环或多种交互界面 |
| 过程记录 |
以对话记录为主,工具调用记录零散缺失 |
需要使用者自行搭建日志规范 |
会话完整保存消息、工具入参返回结果、上下文信息,可对接遥测组件 |
业务需要溯源复核,搭建完整审计链路 |
| 权限控制 |
完全依赖平台内置默认规则 |
需要开发者从零实现权限逻辑 |
在工作区、执行策略、会话默认权限基础之上叠加管控规则 |
文件写入、命令执行、子任务委派需要差异化权限管控 |
| 交付维护成本 |
成本低,适合短期产出结果 |
成本中等,需要自行维护脚本与运行环境 |
前期学习、配置成本偏高;后期迭代维护可控性强 |
面向长期迭代开发,支持团队协作场景 |
选择插件化运行平台,收获的是组件自由组合、灵活替换的能力,但代价是需要承担对应的学习与配置工作。如果项目面向真实业务环境,看重长期迭代以及可追溯交付,这份投入具备实际价值;如果任务只是简单问答,不需要产出可维护成果,那么另外两类轻量化方案会更加高效。DeepSeek Harness 的核心理念为 “Everything is a plugin”(一切皆插件),依托 Cordis 框架完成能力调度与运行,是插件化运行平台范式下的典型实现。
有几类业务场景和DeepSeek Harness 的设计理念高度匹配,可以优先考虑采用该平台。
• 多能力组合、分步决策,需要完整过程可回溯:本书模拟灯光秀项目就是典型案例,完整流程包含输出文件创建计划、人工确认写入操作、浏览器验证页面效果全流程,同时留存对话记录与文件变更记录,便于事后复核。
• 支持局部替换,业务可以逐步演进:先基于 Web 交互界面验证业务流程与审批机制,后续切换 headless 模式接入 CI 流水线;也可以在不中断现有业务流程的前提下更换模型服务商与默认模型。
• 权限管控与审计合规诉求:要求命令执行、文件编辑操作限定在工作区范围内部,依靠执行策略加上人工确认实现多层约束。
• 面向长期维护迭代:希望把单次运行得到的临时输出转变为可持续迭代的工程文件,后续依托任务记录与材料链完成复盘优化。
以上场景可以充分发挥平台优势:借助工作区 + 会话 + 过程记录把客观事实和模型输出结论分离开,再依靠可替换的模型、工具插件完成系统迭代,把一次性实验快速沉淀为团队可复用的持续工作能力。
当然,插件化运行平台并非万能方案,部分简单任务引入该平台反而徒增复杂度。
• 一次性问答或者轻量文本摘要任务:不需要读写本地文件,无需留存过程记录,也没有后续迭代维护诉求。
• 输出结果不需要落地持久化:例如临时信息查询,只需要获取即时文本反馈,不需要保存产出物。
• 无需权限分层、不需要调用外部工具:仅依靠纯文本问答就能够完成全部目标。
遇到上述场景,承担插件化平台带来的学习与配置成本得不偿失。项目前期可以借助图1‑3的选型路径快速自检:倘若过程记录、权限控制、交付维护都属于低优先级诉求,就不必采用Harness方案。当业务真正产生可追溯交付的硬性需求时,再来实践本书介绍的整套方案会更加合理。
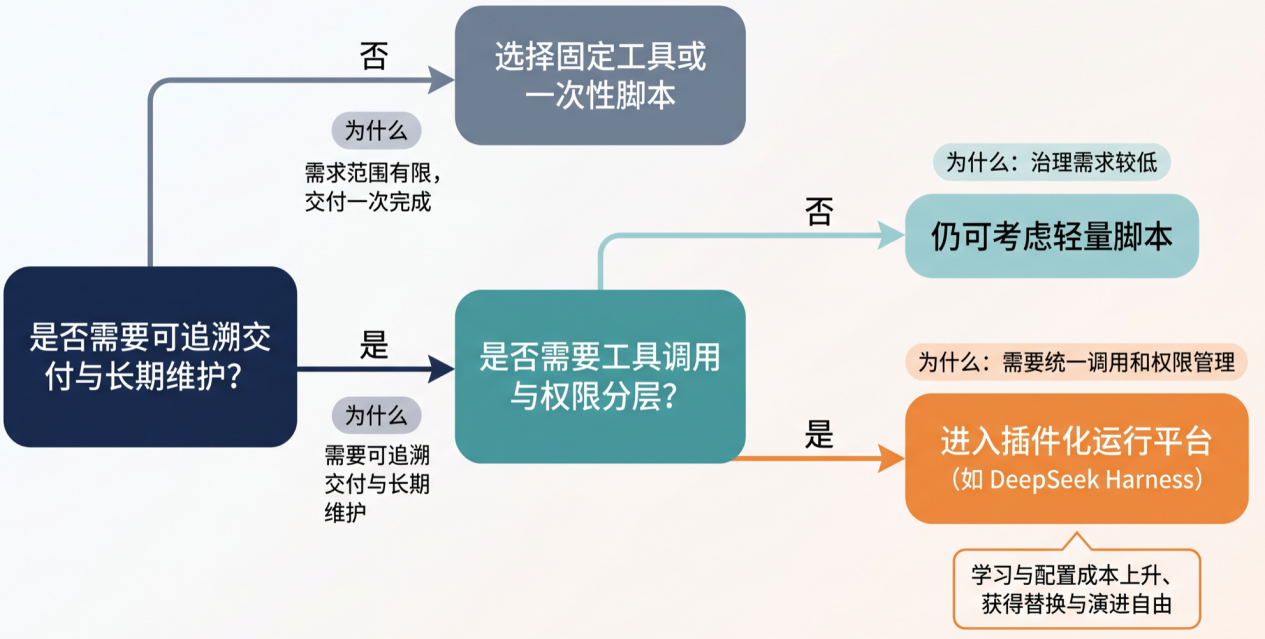
图1-3 选择路径——从需求到方案的分叉
本章围绕核心问题 ——为什么选择DeepSeek Harness 展开完整论述。我们厘清了大模型、智能体与运行平台三者的职责边界:大模型承担语言理解与推理生成工作;智能体在任务目标与上下文约束下完成各类执行动作;运行平台则负责将智能体的行为落地到真实环境,配套权限管控、过程留痕机制,最终产出具备可维护性的交付物。
DeepSeek Harness以 “Everything is a plugin”(一切皆插件)作为核心工程设计思想,将模型、工具、技能、会话、执行循环、调度模块、用户界面等组件,抽象为可以自由组合、替换扩展的能力单元。这套架构显著提升了平台对不同业务环境的适配能力,但与此同时,也会带来相应的学习成本与配置复杂度。
本书以第3章将要实践的模拟灯光秀前端项目作为示例,串联起一条完整的任务材料链:模型构想 — 文件变化 — 任务记录 — 人工确认 — 浏览器验收。这里需要特别说明,平台所强调的可追溯能力,并不等同于系统自带天然合规能力,也无法做到对任务场景的百分之百完整复现。
本章最后借助能力对比维度表与选型决策路径图,划分出工具的适用与不适用边界。如果项目存在多能力组合、权限管控、审计溯源以及长期迭代演进的诉求,投入插件化运行平台是有价值的;但如果只是简单一次性问答,也不需要交付成果与事后复核,选用更加轻量化的方案会更加高效。
基于本章梳理的选型依据与工程原理,后续章节将为读者介绍低成本、可复现的环境启动与任务执行实操步骤。
上一章我们完成了DeepSeek Harness的选型分析,明确了插件化运行平台的价值与适用边界。本章进入实操环节,带领读者搭建一套安全可控的本地运行环境。环境搭建是后续全部实验的基础,环境配置不当会引发权限泄露、运行报错、文件越权修改等各类问题,因此本章会把版本约束、安装步骤、凭据安全、目录隔离等安全要点贯穿始终。
想要运行DeepSeek Harness,首先需要完成底层运行时、包管理工具的部署,妥善管理模型密钥,同时做好实验目录隔离,从源头降低误操作带来的风险。
DeepSeek Harness(下文简称为DSH)目前仍处于开发者预览阶段。本章内容基于发布快照版本0.1.1‑rc.2撰写;后续版本迭代有可能引入不兼容变更。延续 “一切皆插件” 的设计理念,DSH 将模型、工具、技能、会话、沙箱、存储、执行循环、调度模块、用户界面全部设计为可组合、可替换的能力单元。
对于零基础读者,首先要厘清几个容易混淆工具的概念。
• Node.js:执行 JavaScript 代码,是运行各类 JS 工具以及 DSH 的底层运行时。
• npm:伴随 Node.js 一并安装的包管理工具,用于下载 JavaScript 软件包。
• npx:同样由 npm 提供,属于命令行临时执行器,可以直接运行 @deepseek‑ai/dsh;
• pnpm:项目源码开发所使用的包管理器。
注意:不需要单独下载安装npm;正确部署 Node.js 之后,npm 和 npx 会自动配套安装完成。
DSH 对运行环境有明确版本约束:Node.js 版本要求为 ^22.19.0 || >=24.0.0;项目源码固定使用 pnpm@11.7.0。本书撰写时 Node.js 官方提供 24.x LTS 长期支持版本,该版本既满足 DSH 的版本范围,同时稳定性高,非常适合新手上手。 如果仅做快速体验,只需要 Node.js、npm、npx;只有当需要从源码编译运行,或是开展自定义插件二次开发时,才额外需要安装 pnpm 和 Git。各类工具之间的依赖关系参见图2‑1。
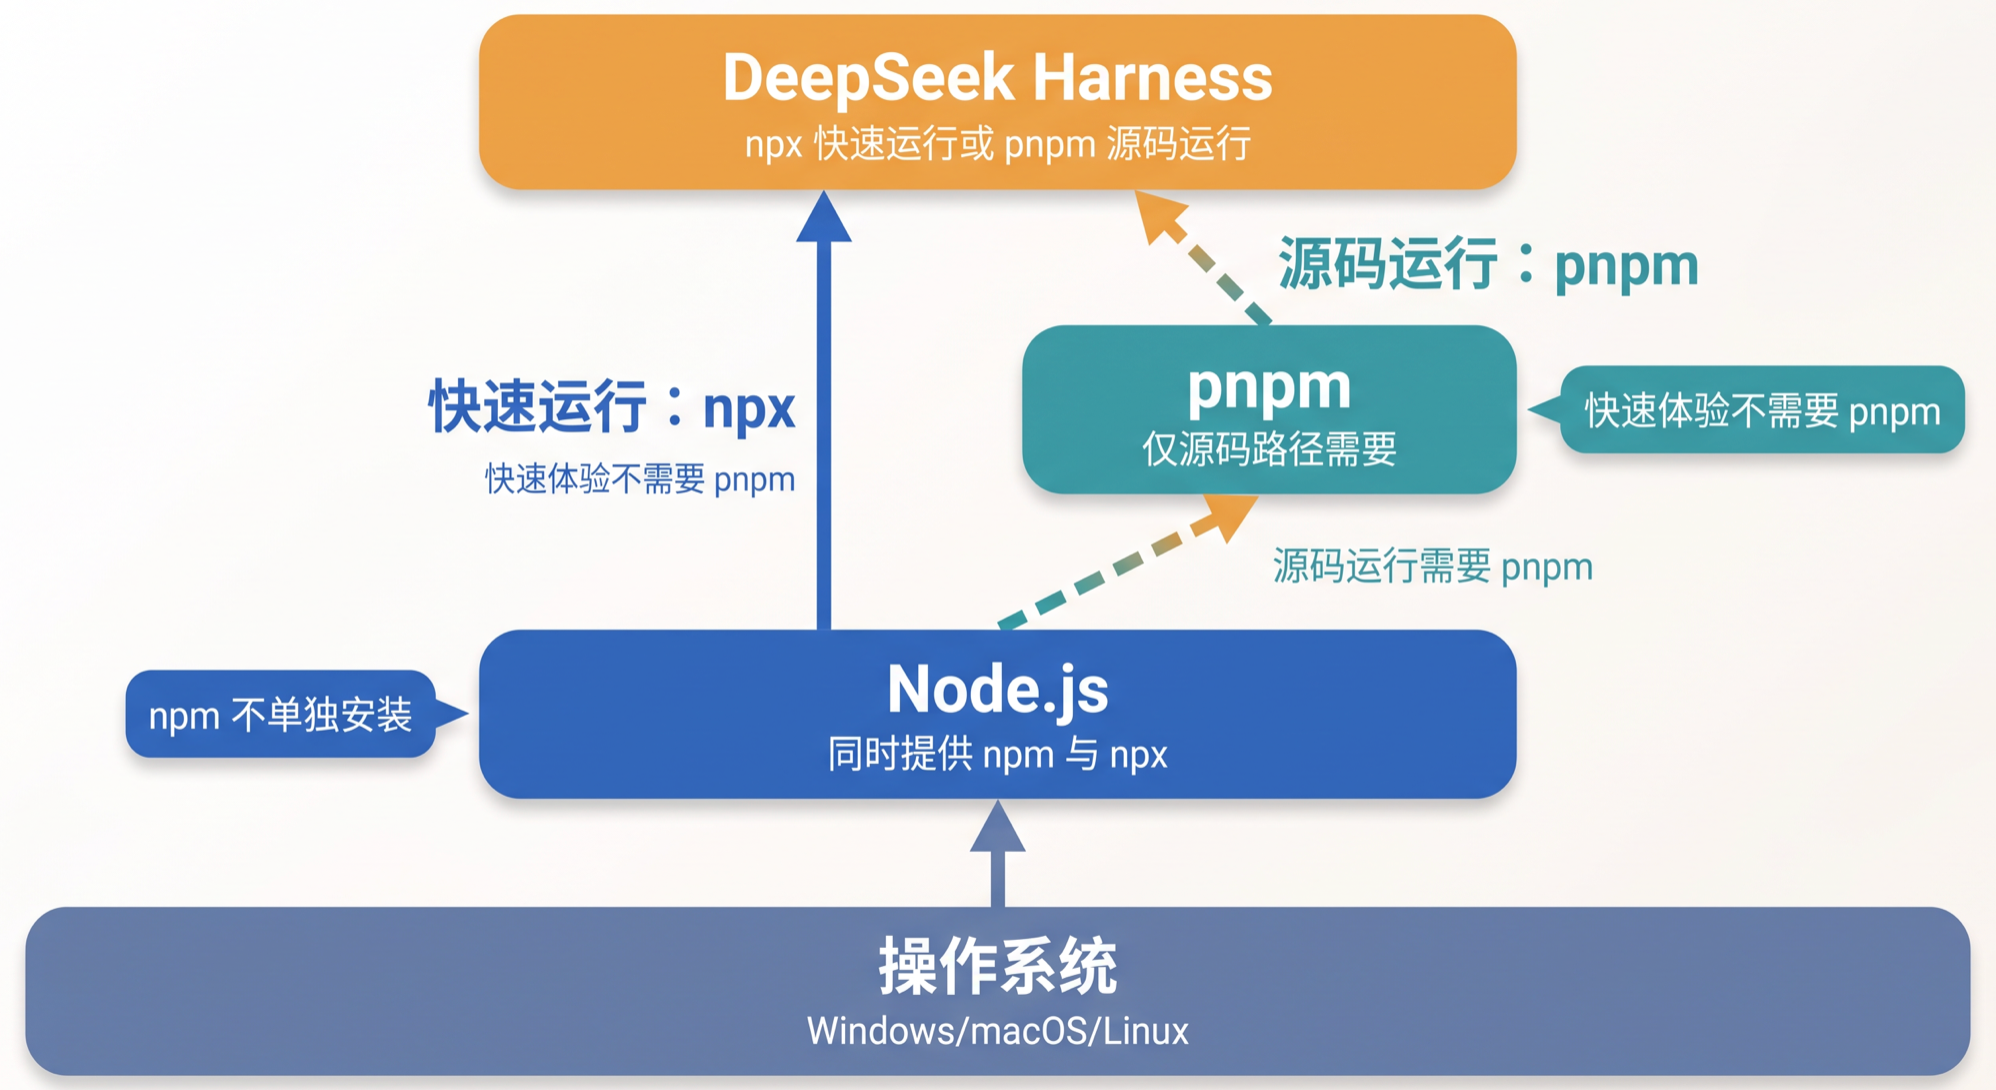
图 2-1 从零准备 DSH 环境的三层关系
在开始安装之前,优先做环境版本校验。如果本机已经安装过 Node.js,请打开终端执行下面三条命令。三条命令均正常输出版本号,代表环境就绪,可以直接跳转至「安装 pnpm」小节;倘若 node‑v 输出版本低于 22.19,或是任意命令提示找不到命令,则需要按照对应操作系统的指引重新安装,或是修复系统环境变量。
    Bash
    node -v
    npm -v
    npx -v
对于没有开发环境配置经验的读者,最稳妥的方案是访问 Node.js 官网下载页 https://nodejs.org/en/download,选择标记为 LTS 的 Windows Installer(.msi)安装包,下载后双击启动安装向导。
安装过程保持默认安装路径,务必确认 Add to PATH(添加至系统环境变量)选项处于勾选启用状态,该选项决定 PowerShell 能否识别 node、npm、npx 命令。安装完成后,必须关闭全部已经打开的 PowerShell、命令提示符窗口,重新开启终端,再执行上面的版本校验命令。
npm 官方文档提到,多版本管理场景可以选用 nvm‑windows;但本书入门实验不需要版本管理器,直接使用官方LTS安装包就足够使用。图2‑2展示命令行安装与 msi 安装包下载入口。
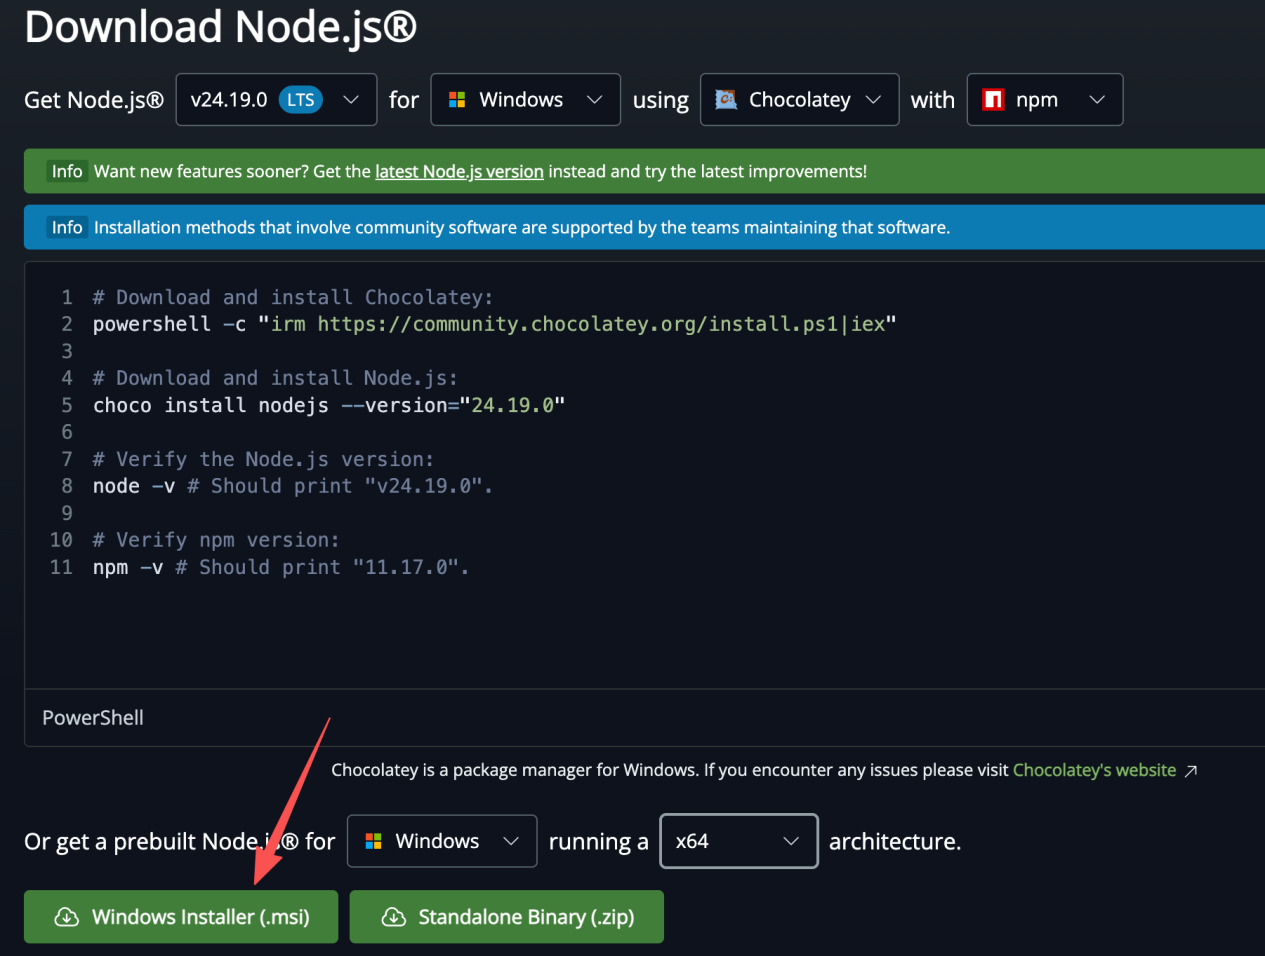
图2-2 Windows安装Node.js
访问https://nodejs.org/en/download,下载标记 LTS 的 macOS Installer(.pkg)安装包,根据设备芯片架构选择对应的安装程序,双击按照向导完成安装。安装结束后完全退出终端再重新打开,执行 node -v、npm -v、npx -v 完成校验。
如果你已经熟练使用 Homebrew、nvm,在团队规范允许的前提下可以采用上述工具;但初次实践的读者,推荐直接使用官方安装包,可以规避 Shell 初始化、PATH 路径异常、版本切换带来的各类排错成本。nvm 只是 macOS/Linux 的可选版本管理工具,并不是运行 DSH 的必备组件。图 2‑3为 macOS 环境下命令行与 pkg 安装包下载入口。
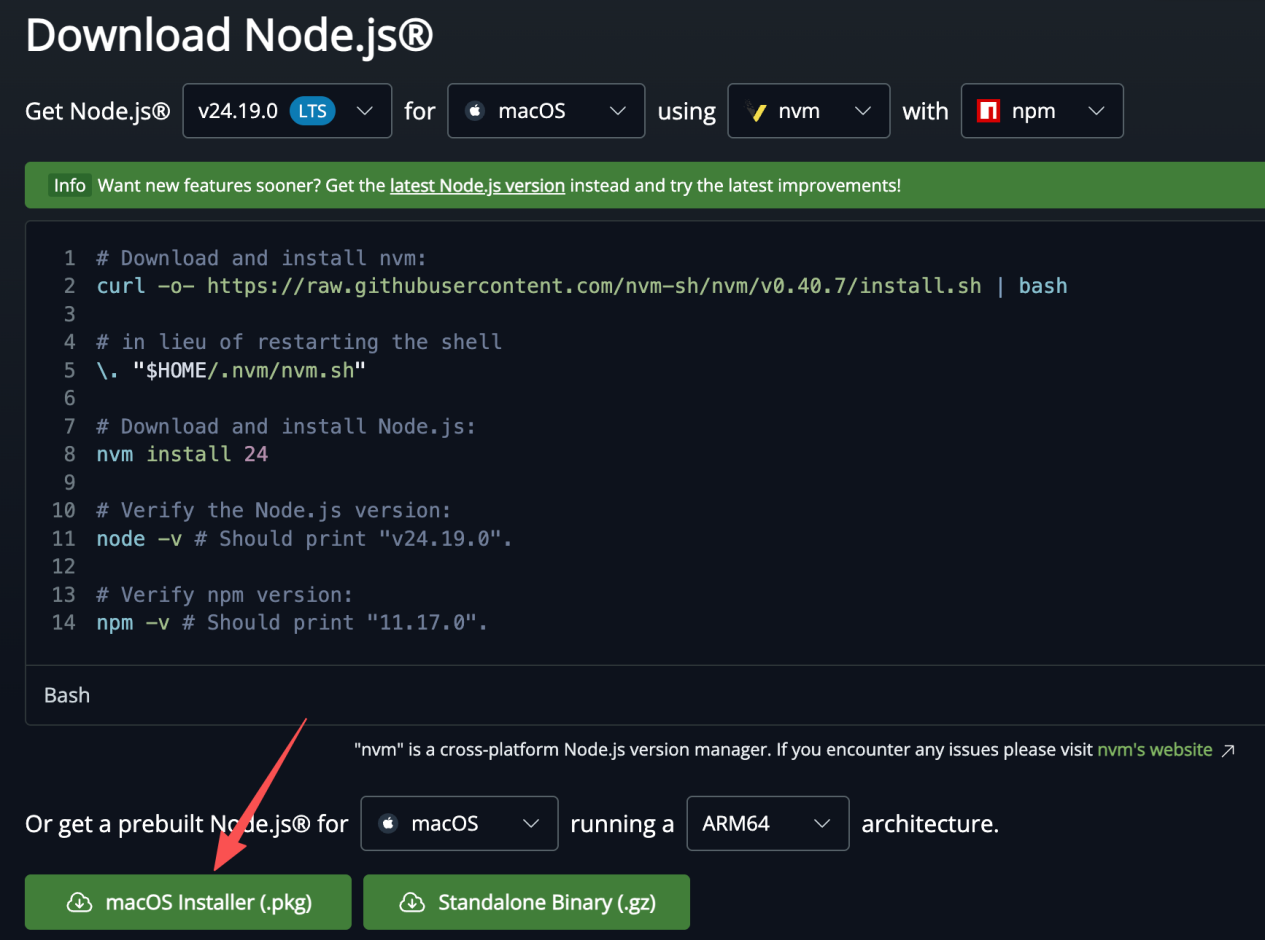
图2-3 mac安装node.js
Linux 各个发行版差异较大,Ubuntu 的安装命令不能直接复制到 Fedora、Arch、Alpine 系统中执行。npm 官方推荐 Linux 用户使用 NodeSource 安装脚本或者 Node.js 官方文档给出的发行版部署指南。表2-1给出 Debian/Ubuntu、Fedora/RHEL 两大主流系列的实操示例。
注意:下面的安装操作需要管理员权限,用于部署系统级运行时;但后续运行 DSH、安装依赖、执行实验任务,务必切换回普通用户账号,不要滥用 sudo。
表2-1 不同Linux发行版安装Node.js 24LTS
| Linux类型 |
安装 Node.js 24 LTS 的示例步骤 |
安装后验证 |
|---|---|---|
| Debian / Ubuntu |
sudo apt-get update sudo apt-get install -y curl ca-certificates curl -fsSL https://deb.nodesource.com/setup_24.x | sudo -E bash - sudo apt-get install -y nodejs |
node -v npm -v |
| Fedora/RHEL版本 |
sudo dnf install -y curl curl -fsSL https://rpm.nodesource.com/setup_24.x | sudo bash - sudo dnf install -y nodejs |
node -v npm -v |
| 其他发行版或受限机器 |
查阅 Node.js 官方 Linux 包管理文档,匹配自身发行版、CPU 架构以及企业内部规范,不要跨发行版混用包管理脚本 |
依旧执行三条版本校验命令做最终确认 |
安全提示:表格中 curl | sudo ... 这类写法,会使用管理员权限执行远端拉取的脚本。仅建议在确认域名属于 NodeSource 官方、并且操作系统在支持列表内使用。如果企业组织策略禁止此类执行远端脚本的方式,请改用企业内部软件源、Node.js 官方二进制压缩包或者运维提供的标准化镜像。即便 NodeSource 被 npm 官方认可为可用安装源,在不清楚来源的情况下,永远不要直接执行网络下载的 Shell 脚本。
确认 npm -v 可以正常输出版本信息之后,在普通用户终端执行下面命令:
    Bash
    npm install --global pnpm@11.7.0
    pnpm -v
第一条命令通过 npm 安装项目锁定版本的 pnpm;第二条命令输出应当为 11.7.0,如图2‑4所示。
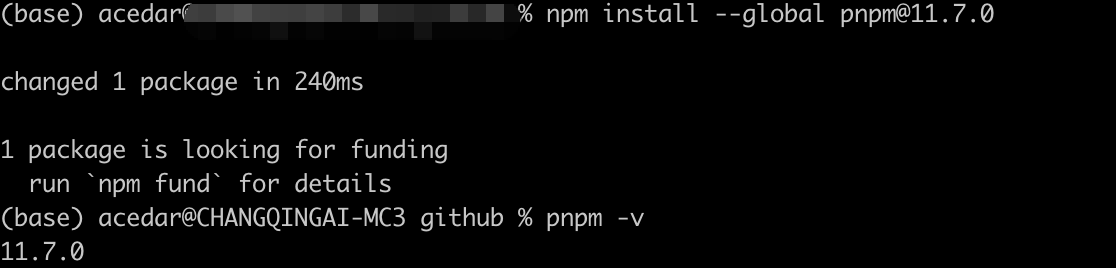
图2-4 安装并查看pnpm版本
pnpm 官方还提供 winget、Homebrew、Scoop、独立二进制包等多种安装途径,入门阶段优先使用 npm 指定版本安装,减少环境变量带来的不确定因素。 pnpm 11 最低要求 Node.js 22,如果 pnpm 安装报错,请优先回溯检查 Node.js 版本,不要反复重试安装命令。常见故障与排查方式如表2-2所示。
表2-2 安装基础环境常见原因及处理方法汇总
| 现象 |
最常见原因 |
面向新手的最小处理 |
|---|---|---|
| node、npm或npx提示不是内部命令/command not found |
安装程序未写入系统PATH;或者终端窗口是安装操作之前打开的旧会话 |
关闭全部终端重新打开;Windows执行where.exe node,macOS/Linux执行which node;依旧无输出,重新运行官方LTS安装包,确认PATH选项开启 |
| node‑v输出18.x、20.x或者更低版本 |
系统内残留旧版本Node.js |
根据团队规范卸载旧版本,或者使用版本管理器切换,安装指定版本 |
| npm install --global pnpm@11.7.0 报权限错误 |
npm全局目录当前用户没有写入权限 |
不要长期使用管理员权限运行npm;核查Node安装来源与npm全局目录,优先使用用户级版本管理器或者运维提供的开发环境后重试 |
| pnpm‑v提示命令找不到 |
npm 全局 bin 目录未加入系统 PATH |
重启终端;Windows执行where.exe pnpm.*,macOS/Linux执行which pnpm;定位文件位置后修正环境变量 |
| 安装被企业代理、证书、终端安全软件阻断 |
企业内网环境安全策略限制 |
不要关闭安全防护、不要绕过组织策略;向运维人员申请Node 24 LTS、pnpm 11.7.0的可信内部安装源 |
完成基础工具部署之后,可以选择两种运行模式:只想快速体验 Web 界面,直接运行 npx @deepseek‑ai/dsh web;如果需要阅读、修改源码或是参与项目贡献,再参考后续章节 Git + pnpm 源码构建流程。官方 README 还支持参数 npx @deepseek‑ai/dsh web --no‑open,启动本地服务但不会自动唤起浏览器,适合远程服务器终端,或是希望手动复制访问地址的场景。
表2-3所示为完整环境自检清单,搭建完成后逐项核对。
表2-3 环境检查清单
| 检查项 |
通过标准 |
检查目的 |
|---|---|---|
| 操作系统与用户账户 |
明确操作系统类型(Windows/macOS/Linux 发行版);日常操作全部使用普通用户账号 |
不同系统安装、权限逻辑不一样;DSH 不建议使用管理员身份运行。 |
| Node.js / npm / npx |
node‑v 为 22.19.x 或者 24.x 以上受支持版本;npm‑v、npx‑v均正常输出 |
Node.js 会附带 npm、npx,是 DSH 两种运行方式的共同前置条件。 |
| pnpm |
源码模式下 pnpm‑v 输出版本 11.7.0 |
项目仓库固定使用 pnpm@11.7.0 做依赖解析。 |
| Git |
源码模式 git‑‑version 正常输出版本 |
用于拉取源码仓库、版本记录、获取新版本代码。 |
| 端口 |
本机回环地址 127.0.0.1:3080 没有被其他程序占用 |
Web 模式默认服务监听地址。 |
| 实验工作目录 |
创建独立练习目录,目录内不存放密钥、生产仓库、敏感业务文件 |
缩小实验误操作的影响范围。 |
| 网络边界认知 |
清楚本地运行依然会产生模型调用、工具相关网络请求 |
workspace‑write权限不等于离线环境,也不等于完整网络隔离。 |
DSH 的模型密钥在前端界面属于只写字段;密钥保存之后,页面只会展示脱敏标识,真实凭据存放于 $DSH_HOME/.credentials.yaml,配置文件中只保存凭据引用,不会存储明文密钥。
请为环境变量 $DSH_HOME 分配仅当前用户可读可写、不会被版本控制系统追踪的目录。严禁将密钥写进提示词、报告、截图、代码提交记录以及共享文件夹,避免凭据泄露。
非交互模式运行时,凭据读取优先级顺序为:继承系统环境变量 → $DSH_HOME/.credentials.yaml → 当前启动目录下 .env → $DSH_HOME/.env。由此可见 .env 只是普通的环境配置层,不能替代专门的凭据管理文件。如果临时使用 .env,务必把该文件加入版本控制忽略列表。
Provider ID 是模型服务商的持久唯一标识,接口请求、保存的会话、默认模型配置、凭据引用全部依赖该 ID。如果需要更换服务商标识,正确做法是新建服务商配置、删除旧配置,不要直接修改已有 Provider ID。 模型或者服务商配置修改完成后,下一次接口请求即可生效,无需重启服务;已经发起的会话,会沿用会话日志中记录的原有模型配置。
自定义模型与合规边界说明:DSH遵循插件思想,模型属于可替换组件。接入第三方自定义模型前,请务必查阅服务商的调用频率限制、内容安全策略、计费规则。文本、图像输入输出的合规约束、内容过滤规则、报文大小限制均以对应模型服务商文档为准,需要自行在本地开展测试验证,DSH 本身不承担模型侧的合规责任。
第3章实操案例需要一套独立、可随时删除的练习项目目录。切勿直接把智能体任务跑在正在使用的业务项目目录内,绝对不要将密钥、客户资料、生产代码、个人文档放入实验目录。本书统一将练习目录命名为 dsh‑light‑show/,专门存放本地无外部依赖的模拟灯光秀前端项目。
选择该示例任务的优势十分直观:最终产出可以直接在浏览器打开预览,读者不需要掌握复杂开发框架,也不用提前安装各类依赖。
在本机普通用户具备读写权限的位置创建空目录即可。
在Windows中,可在 PowerShell 中执行 mkdir dsh-light-show后进入目录;macOS或Linux可在终端执行 mkdir -p dsh-light-show && cd dsh-light-show。此时不需要执行 npm install,也不需要手动创建 package.json 文件。第 3章会由 DSH 在获得你的确认之后,生成 4 个静态文件,文件清单和用途如表2-4所示。。
表2-4 灯光秀项目文件清单与权限约束
| 文件 |
作用 |
是否允许智能体创建/修改 |
|---|---|---|
| index.html |
页面结构、交互按钮与说明文本 |
允许,必须提前展示修改计划,获得人工确认 |
| style.css |
深色舞台样式、灯光色彩与动画效果 |
允许,必须提前展示修改计划,获得人工确认 |
| app.js |
播放 / 暂停、主题切换交互逻辑 |
允许,必须提前展示修改计划,获得人工确认 |
| README.md |
说明项目文件用途与页面打开方式 |
允许,必须提前展示修改计划,获得人工确认 |
除上表内 4 个文件之外,智能体不应当新增或者改动其他任何内容。尤其需要拒绝安装 npm 包、生成 node_modules/、引入 CDN 资源、联网下载素材、删除文件、读取工作区以外文件、启动对外服务等行为。
注意:自然语言层面给出的约束,不能替代系统权限管控。执行第 3 章任务时,工作区务必只选定 dsh light show/;每一次写入操作前,请仔细阅读智能体输出的变更计划和影响范围。
目录准备完成后,不需要手动编写页面文件。直接把空目录作为 DSH 的工作区,交由智能体先输出创建计划,经过人工确认之后,再执行写入操作。这样就将本章学习的工作区选择、安全边界控制,与第 3 章真实任务完整衔接起来。
完成基础运行环境准备之后,接下来我们可以启动 DeepSeek Harness 运行实例。平台提供两种主流使用路径:一种是 npx 直接拉起图形界面,适合快速上手体验;另一种是完整源码编译构建,面向调试、二次开发场景。同时还支持 headless 无图形界面模式,用于自动化、CI 流水线等非交互场景。
快速启动 Web 图形界面,最简便的命令如下,该方式也是官方 README 文档推荐的入门体验方案:
npx @deepseek-ai/dsh web。
执行完成后,Web 服务默认监听 http://127.0.0.1:3080。
重要说明:dsh web 本质是 web profile 的命令别名。虽然 CLI 启动时会把当前所在目录视作默认工作区根目录,但 Web UI 并不会自动继承该目录。必须在界面手动添加并选中目标工作区,才能够提交任务、执行各类工具操作,这一点在 Web 使用指南与 CLI 文档中均有明确说明,很多新手容易忽略这一步而产生操作异常。
网络绑定安全策略:当前版本 CLI 会直接拒绝 --host 0.0.0.0 参数,Web 服务默认仅对本机回环地址开放访问。入门实验务必维持默认配置,不要把尚未完成权限、凭据、工作区安全校验的预览服务暴露至局域网或者公网。 如果只希望启动服务,但不自动唤起浏览器,可以追加参数 --no‑open,启动完成后手动复制控制台输出的地址,在浏览器访问即可。
按照图 2‑5 所示执行命令,npx 会自动拉取对应最新版本,启动成功后会自动弹出 Web 网页,效果参考图 2‑6。
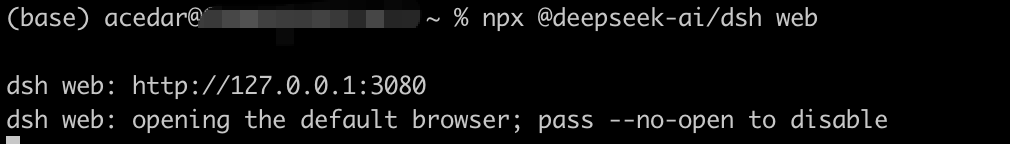
图2-5 命令启动DeepSeek Harness
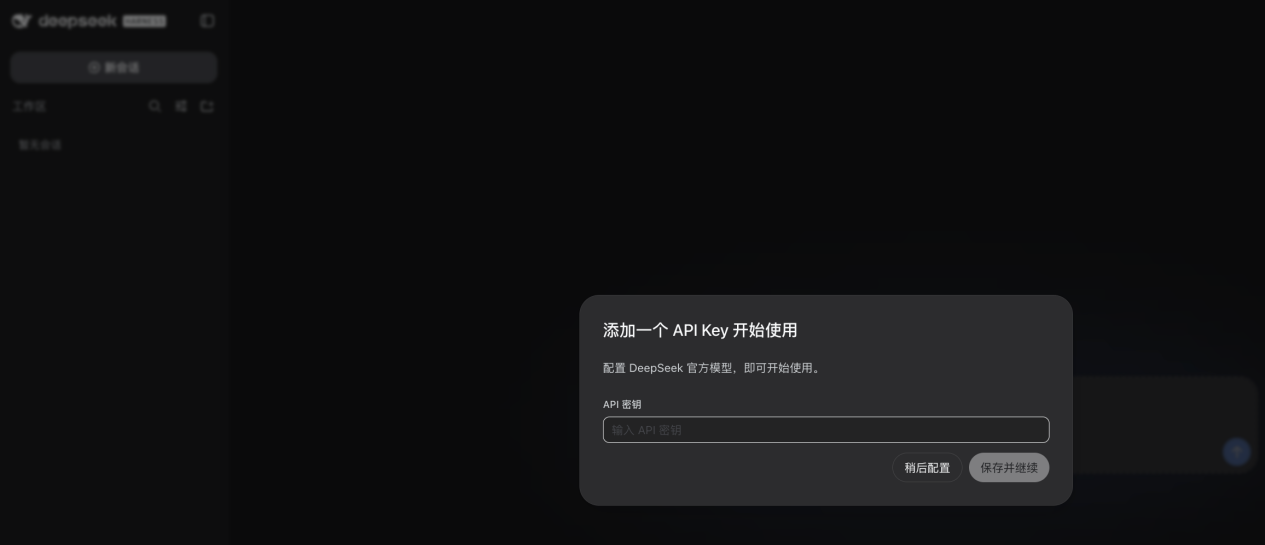
图2-6 DeepSeek Harness Web启动页面
这里我们先跳过API密钥配置环节,后续在系统设置页面完成配置;通过设置界面配置是通用方式,除DeepSeek官方模型之外,也可以适配其他第三方模型服务商。本书以 DeepSeek 官方模型接入流程作为示例讲解。
服务首次运行完成后,可以查看~/.dsh(macOS/Linux)目录,该目录为 DSH 的家目录$DSH_HOME,内部包含 profile 配置、凭据、缓存等全部运行数据。目录内会生成node_modules,存放平台编译后的产物,文件数量较多,不再逐一罗列,完整目录结构参考图2‑7。
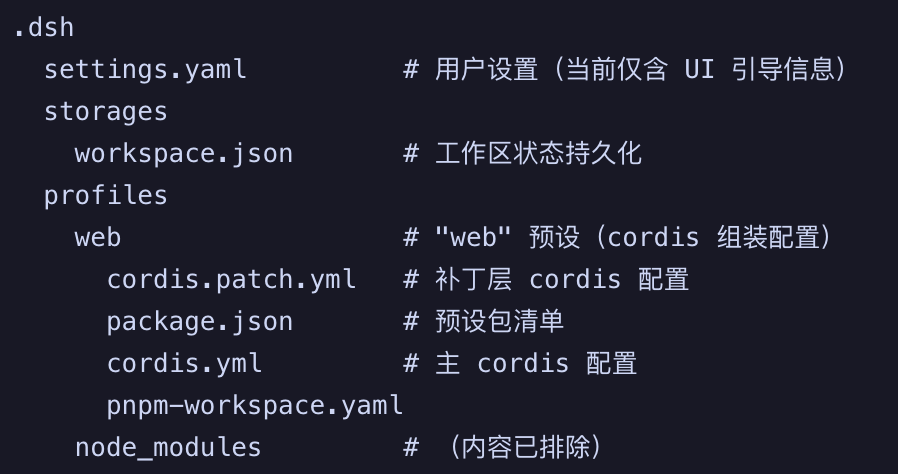
图2-7 首次启动后~/.dsh目录文件结构
无图形界面headless模式:headless模式用于拉起持久化会话,不需要 HTTP Web 服务,运行结果输出至标准输出 stdout。任务执行成功退出码为0,任务异常终止退出码为1,适合自动化脚本、CI 流水线场景,不会监听任何端口。
想要在任意终端直接调用dsh命令,需要先全局安装指定版本包:
    Shell
    npm i -g @deepseek-ai/dsh@0.1.1-rc.2   # 全局安装指定快照版本

    which dsh          # 应输出 /opt/homebrew/bin/dsh
    dsh --version      # 应输出 0.1.1-rc.2

     # headless模式执行任务,引号内部替换为你的实际任务描述
    dsh --profile headless "任务"
如果需要阅读源码、本地调试或是参与项目开发,可以选择源码编译运行方式。官方给出最小可复现流程:克隆代码仓库,执行依赖安装,执行构建,再调用本地 dsh 脚本启动 web profile,这套流程在项目 README 以及package.json脚本定义中都有记录。完整命令序列如下:
    Markdown
    # 拉取项目源码仓库
    git clone https://github.com/deepseek-ai/deepseek-harness.git
    cd deepseek-harness

    # 安装全部项目依赖,同步执行postinstal,配置lefthook git钩子
    pnpm install

    # 执行完整构建:生成TypeScript类型声明、Web前端编译产物
    pnpm run build

    # 使用本地构建产物,启动Web UI(默认地址http://127.0.0.1:3080)
    pnpm dsh web
源码开发流程涉及三个关键阶段,三者分工不同,需要分清彼此作用:
• typecheck:对 TypeScript 源代码做静态类型检查,主要用于开发阶段提前捕获代码类型错误;该步骤不会生成运行产物,属于质量校验环节,不是运行必需步骤。
• build:编译打包源代码,输出 dist 目录等运行时资源,CLI 执行时完全依赖 build 产出的文件,是源码部署必不可少的环节。
• dsh(CLI 入口):平台命令行执行入口,加载 build 编译完成的产物,初始化 Web 服务、headless 会话等各类能力。因此源码调试标准顺序一般为:typecheck(可选) → build → dsh。实际脚本名称以仓库package.json内定义为准。
两种启动路径选型参考: 仅做功能体验、快速验证场景,优先选择npx方式,操作简单,环境隔离成本更低;需要修改源码、调试底层逻辑、复现项目 Bug 时,则克隆仓库,使用 pnpm 完整源码链路。
补充区别:npx属于临时执行,不会在本地留存完整源码与构建产物;源码构建模式则具备更高调试可控性,两种方案根据自身实际目标取舍。
本节包含两大核心操作:在图形界面或者命令行环境中接入模型服务、选择可用模型;理解工作目录机制,确认访问边界与约束。 大量实际报错都来源于模型配置异常、工作区选择错误。不管是自动化脚本还是教学实验,完成实验前,这两项都必须重点检查。
接入模型分为两个核心步骤:注册 Provider,也就是模型服务商端点与元信息;再从已注册服务商中挑选具体模型。需要重点掌握凭据存储规则、Provider ID 的约束、模型配置生效逻辑。
关键操作要点如下。
• 密钥写入与存储规则:Web 前端的密钥输入框属于只写字段,保存之后界面只会展示脱敏标识,不会回显明文密钥。真实凭据存储在$DSH_HOME/.credentials.yaml。请确保当前用户对该路径拥有读写权限,妥善保管该文件。不能通过界面脱敏字符反推原始密钥;多人共享环境严禁直接共享该凭据文件,防止密钥泄露。
• Provider ID 约束:Provider ID 是系统内部引用服务商的稳定唯一标识,不建议直接修改已有 ID;强行修改会造成模型调用、权限映射、会话引用出现异常。如果需要更换服务商标识,正确做法是新增一条服务商配置,删除旧配置条目。
• 配置生效时机:Web 界面或者配置文件修改密钥、模型参数之后,不会立刻全局重载配置,变更将在下一次发起模型请求时生效。修改完成之后建议执行一次简单测试对话,确认配置已经正确加载。
• UI 模型选择逻辑:模型下拉列表展示当前 Provider 下全部可用模型,包含模型名称、规格、推理相关说明。选中模型后,会话在发起请求阶段完成凭据与网络连通校验;常见报错为 401/403 授权错误,或是模型探测失败,代表密钥错误或者网络端点不可达。
模型配置页面如图2‑8所示。初次打开页面可以看到 DeepSeek 官方模型卡片,直接填入 API 密钥即可使用;下方自定义区域支持增删模型条目。举个例子,如果希望节约调用成本,不想使用 DeepSeek‑V4‑Pro,可以直接删除该模型;后续接入其他服务商,点击「添加模型」完成新增。页面最下方支持添加第三方模型服务商,能够兼容各类外部网关,这正是 “一切皆插件” 设计思想的具体体现。
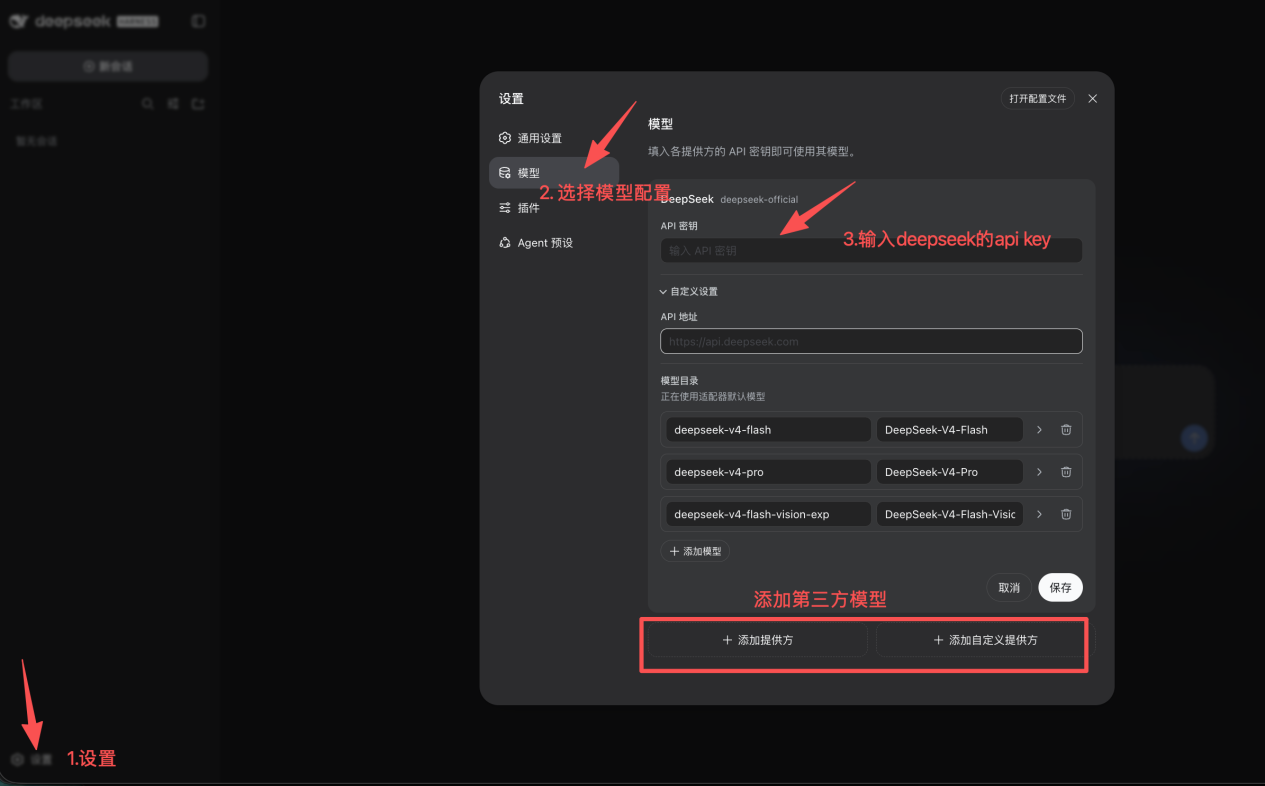
图2-8 新增模型配置界面
本书示例直接使用 DeepSeek 官方模型,需要前往 DeepSeek 开放平台https://platform.deepseek.com/api_keys 创建API密钥,账户需要提前充值获取调用额度,复制密钥填入配置界面即可,如图2-9所示。
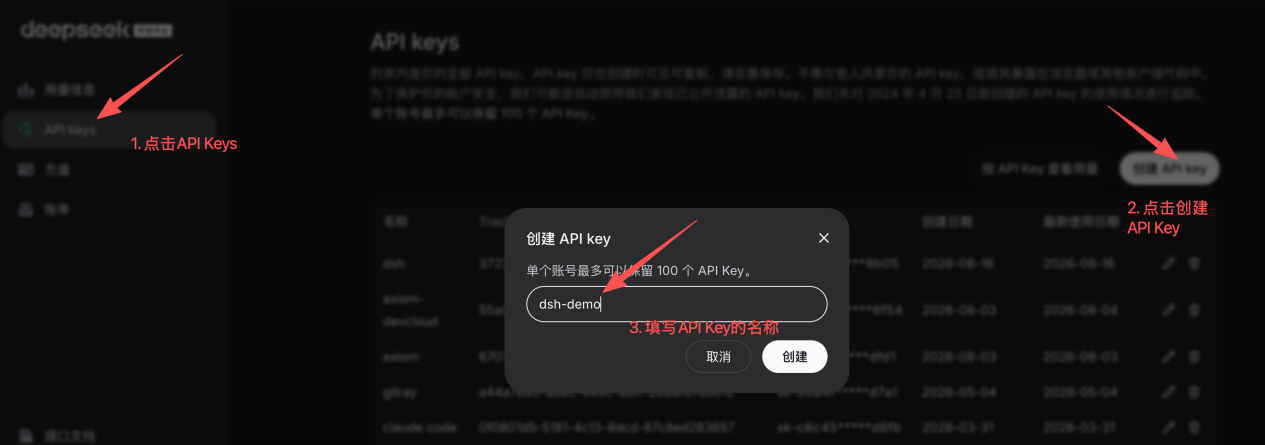
图2-9 DeepSeek开放平台创建API密钥界面
保存配置后回到 Web 首页,即可在模型下拉框看到已经接入的模型,用来验证配置是否生效,见图2‑10。
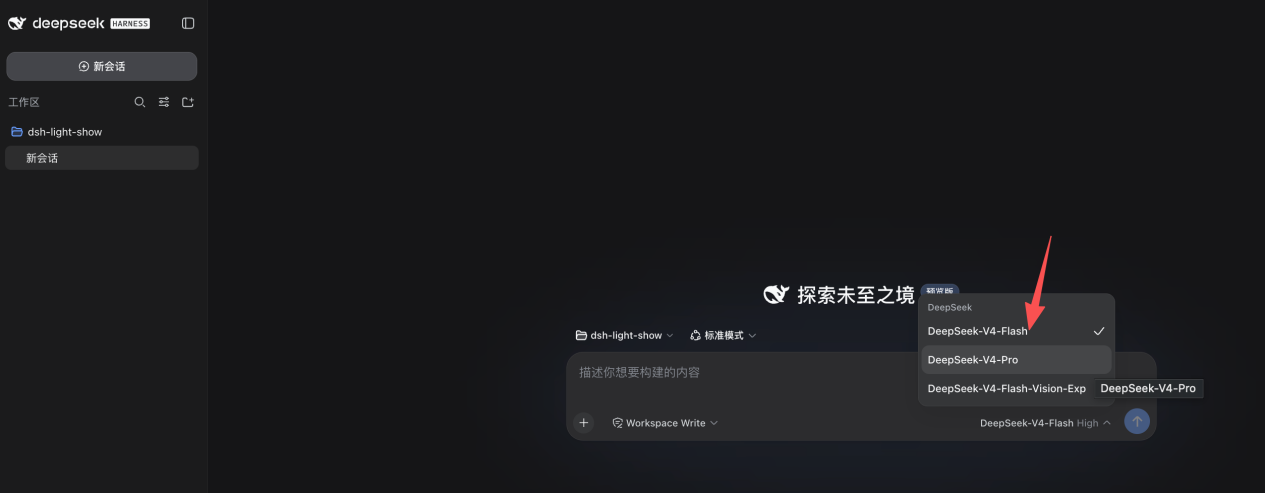
图2-10 校验已配置的服务商与模型
配置完成之后,打开~/.dsh目录,可以看到新增生成的.credentials.yaml文件,所有 API 凭据保存在该文件中,也可以直接编辑该文件完成配置,如图2‑11所示。
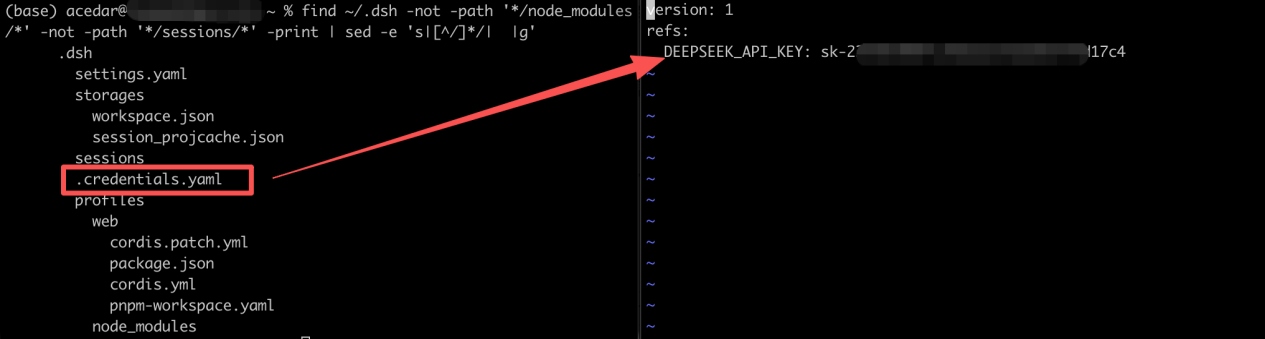
图2-11 API密钥存储文件位置及内容
将密钥独立保存在 DSH 家目录,不会和项目代码混在一起,能够避免密钥被意外提交、泄露,体现平台凭据管理的安全设计。
• 如果模型列表为空,提示UNKNOWN_MODEL:优先核对 Provider 元信息与网络连通;确认$DSH_HOME/.credentials.yaml文件存在、格式合法;核对 Provider ID 和注册记录保持一致。
• 模型探测返回401:确认 API 密钥本身有效,并且归属对应服务商;必要时查看后端日志,分析 HTTP 鉴权相关报错信息。
工作区是 DeepSeek Harness 用来限定智能体操作边界的核心概念。注意当前开发者预览版本,工作区防护能力存在局限,我们必须分清哪些目录允许访问、哪些允许修改,不能过度高估隔离强度。
工作目录与UI交互的逻辑如下。
• 启动目录与 UI 工作区分离:执行dsh web时的终端当前目录会被视作默认工作区根,但 Web UI 不会自动选中该目录。无论命令行处于哪个目录,必须在界面手动添加、选中工作区,智能体才可以执行文件读写、命令操作。
• 工作区选择流程:Web 界面添加并且选中目标工作区之后,新建会话、工具调用都会以这个目录作为上下文。实验前确认工作区处于选中状态,能够规避大量 “未选择工作区”类报错。
• 默认会话权限预设为workspace‑write:Bash 命令、文件修改操作会被约束在当前会话工作区以及平台临时根目录。但是读取文件、网络访问不受这套预设限制。进程可见性取决于底层沙箱后端:bwrap 会启用私有PID命名空间,隐藏主机进程;Landlock、Seatbelt 则依旧能够看到宿主机全部进程。
重要提醒:workspace write不等于完整沙箱,不等同离线环境,也达不到生产环境安全隔离标准,如图2 12所示。
• 实际风险边界:该权限仅降低一部分误写入文件的风险,无法阻断网络请求,也不能限制读取主机其他文件。处理业务敏感数据,仍然需要依靠操作系统账户、目录权限、网络策略多重防护。本书练习目录严禁存放真实密钥、生产业务数据。
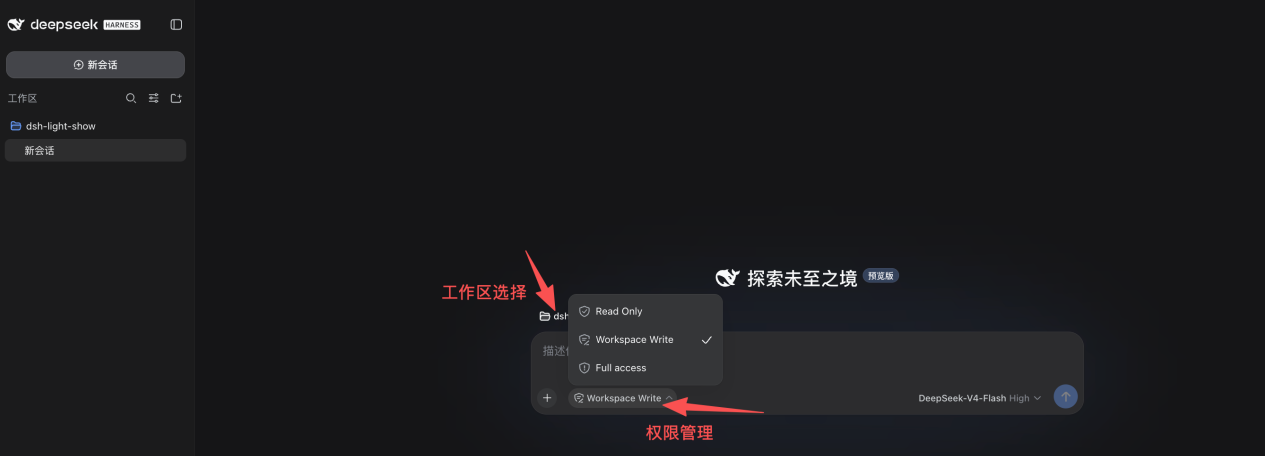
图2-12 工作区权限与 workspace-write预设示意图
虽然可以在终端cd切换至目标练习目录再启动dsh web,降低路径错乱概率,但依旧必须在Web界面完成添加选中操作。
执行高危操作前,人工复核工作区实际路径,避免错误将/home、/root这类系统目录设置为工作区,这是必不可少的人工审计步骤。
完成模型与工作区配置之后,在实际操作过程中经常会遇到鉴权报错、模型识别失败、工作区不生效、端口占用等各类问题。很多新手遇到报错会直接盲目修改配置,反而扩大故障范围。本节把开发预览阶段出现频率较高的故障做归纳整理,每一类问题都会说明具体表现、需要核查的关键点,同时给出可直接执行的处理思路,方便读者按现象对号入座,有序排查定位问题。
当凭据没有正确保存或者文件损坏时,就会触发密钥缺失类故障。
• 现象:模型调用返回鉴权失败,UI 发起请求直接被拒绝。
• 检查点:确认$DSH_HOME/.credentials.yaml存在,包含对应 Provider 配置条目;确认 Web 界面提示密钥写入成功(界面只做脱敏展示)。
• 处置:在 Web 设置页重新填写凭据并保存;发起一次简单测试对话验证配置是否生效(配置变更在下一次请求生效)。
该报错代表系统无法解析当前选中的模型标识,大多来自服务商配置异常或者网络探测失败。
• 现象:模型列表无法识别目标模型,标记 UNKNOWN_MODEL。
• 检查点:Provider ID 和凭据文件记录保持一致;检查网络与服务商端点连通状态。
• 处置:不要直接修改旧 Provider ID;新建服务商配置,填写凭据,再重新选择模型。
401/403 属于 HTTP 鉴权类错误,代表请求已经送达服务商,但身份校验没有通过,需要从密钥本身和服务商侧双向排查。
• 现象:后端返回 401/403,模型可用性探测失败。
• 检查点:密钥是否过期,写入凭据文件格式是否正确;确认服务商侧是否开启 IP 白名单等访问限制。
• 处置:更新有效密钥,核对服务商平台访问策略;查看后端日志,获取 HTTP 鉴权失败详细信息。
如果使用具备多模态能力的模型,上传图片时有可能被拦截,该问题不一定是密钥错误,更多来自模型能力声明、代理或者内容策略限制。
• 现象:上传图片资源直接被前端或者后端拦截。
• 检查点:查看 UI 与后端日志具体报错码;排查是否触发内容合规策略、代理拦截。
• 处置:根据返回错误调整请求内容;受策略限制无法放行时,改用文本形式替代。
这是非常容易被忽略的操作类问题。即便命令行已经进入目标目录,Web UI 仍然需要手动完成工作区的添加与选中,否则智能体无法执行文件、命令相关操作。
• 现象:Web 输入框被禁用,无法下发任务;CLI 行为与 Web 界面表现不一致。
• 检查点:确认 Web 界面已经添加并且选中目标工作目录;CLI 启动目录需要和 UI 选中目录保持匹配。
• 处置:Web 界面添加并选中对应工作区;如需更换工作区根目录,停止服务,切换目录之后重新启动dsh web。
Web 模式默认固定使用本机 3080 端口,如果该端口被其他程序占用,服务就无法正常完成绑定。同时需要牢记平台的网络绑定安全约束。
• 现象:启动报错端口绑定失败,Web 页面打不开。
• 检查点:确认本机 3080 端口被其他进程占用;当前版本禁止使用--host 0.0.0.0参数。
• 处置:停止占用 3080 端口的进程,或者使用 Web 应用参数切换其他本机端口;入门实验不要尝试绕过 host 限制对外暴露服务。
该类故障大多出现在源码编译运行的场景,版本、依赖、编译产物任意一环出错,都会造成界面行为异常。
• 现象:源码编译启动,界面功能异常,版本号和文档描述不符。
• 检查点:核对 git 提交快照;确认 Node.js 版本^22.19.0 || >=24.0.0,pnpm 锁定版本11.7.0。
• 处置:切换到文档对应版本快照,或者改用 npx 快速启动做对照测试;重新执行pnpm install与pnpm run build,阅读构建日志定位依赖、编译报错。
故障排查通用原则:日志是定位问题最重要依据,包含服务启动日志、后端模型调用日志、浏览器控制台日志。涉及第三方模型服务商的问题,也要同步去服务商平台核对密钥状态、调用限额、访问控制策略。
本章围绕实例启动、服务有效性校验、模型与工作目录配置展开完整讲解。
首先区分两种运行方式:npx快速体验模式与源码编译开发模式,并且介绍 headless 无界面模式面向自动化场景的用法。接着讲解模型接入完整流程:密钥只写脱敏存储机制、$DSH_HOME/.credentials.yaml凭据文件、Provider ID 不可随意修改,同时明确配置变更需要等到下一次模型请求才会生效。随后解析工作区概念,着重强调workspace‑write权限仅限制写入操作,并不是完整安全沙箱,敏感业务场景必须叠加操作系统层面防护手段。
书中也介绍了实用调试工具,例如--dump‑config参数可以离线审查合并后的完整配置,headless profile 用来执行无 UI 持久会话。最后整理各类高频故障的排查步骤,遇到报错按照检查点逐项核验,能够大幅缩短问题定位时间。